导言
解释 Scratchpad 时,我们很快会遇到一个新问题:数据由 DMA 显式搬入片上 SRAM,但它从 HBM 到计算核心附近的 Scratchpad,究竟经过了什么?答案里反复出现的 NoC,又是什么概念?
这篇文章沿着一次数据搬运,把几个容易混在一起的对象摆回各自的位置:Scratchpad 负责本地存取,NoC 负责片上运输,DMA 负责执行显式搬运。
1 | Disassembly of section .plt: |
.plt节主要实现了使用过程链接表(Procedure Linkage Table)实现延迟绑定的功能。
问题:objdump 程序 有许多 类似 <.omp_outlined..16>: 的函数,但是main函数里并没有调用。实际openmp是怎么执行这些代码的呢?
在使用了OpenMP指令的C/C++程序编译后,编译器会自动生成一些名为.omp_outlined.的函数。这些函数是OpenMP所需要的运行时支持函数,不是直接在main函数中调用的,其执行方式主要有以下几种:
.omp_outlined.函数创建线程并发布工作。.omp_outlined.函数,在循环分配工作时调用。所以.omp_outlined.函数的执行是隐式通过运行时库触发和调度的,不需要用户代码直接调用。它们是OpenMP实现所必须的,由编译器和运行时库协调完成。用户只需要编写OpenMP指令,不必关心具体的调用细节。
总体来说,这是一种让并行执行透明化的实现机制,减少了用户的工作量。
不同平台不同,有GOMP_parallel_start开头的。也有如下x86平台的
1 | 405854: 48 c7 84 24 a0 00 00 movq $0x4293b9,0xa0(%rsp) |
这段汇编代码实现了OpenMP中的并行构造,主要执行了以下几个步骤:
__kmpc_fork_call函数,这是OpenMP的runtime库函数,用来并行执行一个函数kmpc fork multiple parallel call?所以这段代码实现了调用OpenMP runtime并行执行一个函数的操作,准备参数,调用runtime API,获取返回值的一个流程。
利用runtime库的支持函数可以实现汇编级别的OpenMP并行性。
各section位置以及含义,参考文档
1 | $ readelf -S bfs.inj |
[ 5] .dynsym 有关One section type, SHT_NOBITS described below, occupies no
space in the file, and its sh_offset member locates the conceptual placement in the
file.
so the number “2d258” remains unchanged.
1 | [25] .data PROGBITS 000000000042e258 0002d258 |
global offset table
This section holds the procedure linkage table. See ‘‘Special Sections’’ in Part 1 and ‘‘Procedure Linkage Table’’ in Part 2 for more information.
Function symbols (those with type STT_FUNC) in shared object files have special significance. When
another object file references a function from a shared object, the link editor automatically creates a procedure linkage table entry for the referenced symbol.
暂无
暂无
上面回答部分来自ChatGPT-3.5,没有进行正确性的交叉校验。
无
LLVM项目开始于一种比Java字节码更低层级的IR,因此,初始的首字母缩略词是Low Level Virtual Machine。它的想法是发掘低层优化的机会,采用链接时优化。
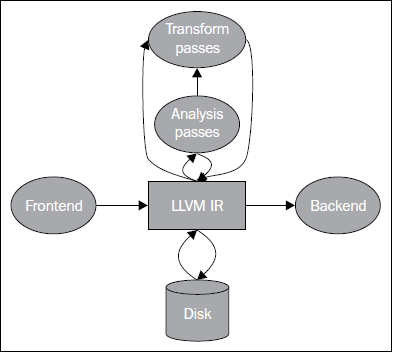
学过编译原理的人都知道,编译过程主要可以划分为前端与后端:
经典的编译器如gcc:在设计上前端到后端编写是强耦合的,你不需要知道,无法知道,也没有API来操作它的IR。
好处是:因为不需要暴露中间过程的接口,编译器可以在内部做任何想做的平台相关的优化。
坏处是,每当一个新的平台出现,这些编译器都要各自为政实现一个从自己的IR到新平台的后端。
LLVM的核心设计了一个叫 LLVM IR 的通用中间表示, 并以库(Library) 的方式提供一系列接口, 为你提供诸如操作IR、生成目标平台代码等等后端的功能。
在使用通用IR的情况下,如果有M种语言、N种目标平台,那么最优情况下我们只要实现 M+N 个前后端。
LVM IR实际上有三种表示:
各种格式是如何生成并相互转换:
| 格式 | 转换命令 |
|---|---|
| .c -> .ll | clang -emit-llvm -S a.c -o a.ll |
| .c -> .bc | clang -emit-llvm -c a.c -o a.bc |
| .ll -> .bc | llvm-as a.ll -o a.bc |
| .bc -> .ll | llvm-dis a.bc -o a.ll |
| .bc -> .s | llc a.bc -o a.s |
对于LLVM IR来说,.ll文件就相当于汇编,.bc文件就相当于机器码。 这也是llvm-as和llvm-dis指令为什么叫as和dis的缘故。
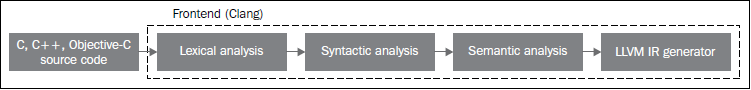
clang实现的前端包括
见 llvm Backend 一文
Clang 是 LLVM 项目中的一个 C/C++/Objective-C 编译器,它使用 LLVM 的前端和后端进行代码生成和优化。它可以将 C/C++/Objective-C 代码编译为 LLVM 的中间表示(LLVM IR),然后进一步将其转换为目标平台的机器码。Clang 拥有很好的错误信息展示和提示,支持多平台使用,是许多开发者的首选编译器之一。同时,Clang 也作为 LLVM 项目的一个前端,为 LLVM 的生态系统提供了广泛的支持和应用。
Clang 的开发起源于苹果公司的一个项目,即 LLVM/Clang 项目。在 2005 年,苹果公司希望能够使用一种更加灵活、可扩展、优化的编译器来替代 GCC 作为其操作系统 macOS (Mac OS X) 开发环境的默认编译器。由于当时的 GCC 开发被其维护者们认为变得缓慢和难以维护,苹果公司决定开发一款新的编译器,这就是 Clang 诞生的原因。Clang 的开发团队由该项目的创立者 Chris Lattner 领导,他带领团队将 Clang 发展为一款可扩展、模块化、高效的编译器,并成功地将其嵌入到苹果公司的开发工具链 Xcode 中,成为了 macOS 开发环境中默认的编译器之一。
Clang 是一个开源项目,在苹果公司的支持下,Clang 的开发得到了全球各地的开发者们的广泛参与和贡献。现在,Clang 成为了 LLVM 生态中的一个重要组成部分,被广泛地应用于多平台的编译器开发中。
Clang and Clang++ “borrow” the header files from GCC & G++. It looks for the directories these usually live in and picks the latest one. If you’ve installed a later GCC without the corresponding G++, Clang++ gets confused and can’t find header files. In your instance, for example, if you’ve installed gcc 11 or 12.
You can use clang-10 -v -E or clang++-10 -v -E to get details on what versions of header files it’s trying to use.
安装g++-12解决
github/tools目录下有许多实用工具
llvm-as:把LLVM IR从人类能看懂的文本格式汇编成二进制格式。注意:此处得到的不是目标平台的机器码。llvm-dis:llvm-as的逆过程,即反汇编。 不过这里的反汇编的对象是LLVM IR的二进制格式,而不是机器码。opt:优化LLVM IR。输出新的LLVM IR。llc:把LLVM IR编译成汇编码。需要用as进一步得到机器码。lli:解释执行LLVM IR。暂无
暂无
文章部分内容来自ChatGPT-3.5,暂时没有校验其可靠性(看上去貌似说得通)。